Context Engineering چیست؟ چرا یک پرامپت خوب برای هوش مصنوعی کافی نیست؟
احتمالاً برای شما هم پیش آمده است که از یک هوش مصنوعی سؤال نسبتاً سادهای بپرسید، اما پاسخی دریافت کنید که با وجود نگارش خوب، دقیقاً متناسب با نیازتان نباشد. گاهی مدل اطلاعات مهمی را که قبلاً به آن دادهاید نادیده میگیرد؛ گاهی به سند اشتباهی تکیه میکند و گاهی هم اطلاعات زیادی در اختیارش قرار میگیرد، اما نتیجه همچنان ضعیف است. در چنین شرایطی اولین راهحل معمولاً نوشتن یک پرامپت بهتر است. این کار واقعاً میتواند مفید باشد، اما همیشه تمام مشکل را حل نمیکند.
Context Engineering چیست؟ چگونه اطلاعات مناسب، پاسخ هوش مصنوعی را بهتر میکند؟
در سیستمهای پیشرفته هوش مصنوعی، مسئله مهم دیگری نیز وجود دارد: چه اطلاعاتی به مدل داده میشود، کدام اطلاعات واقعاً مرتبط هستند و چگونه باید این اطلاعات را در طول اجرای یک وظیفه مدیریت کرد؟ این حوزه با نام Context Engineering شناخته میشود؛ رویکردی که فراتر از نوشتن یک دستور خوب، روی طراحی و مدیریت مجموعه اطلاعاتی تمرکز میکند که مدل هنگام پاسخگویی در اختیار دارد. در این مقاله یاد میگیریم Context Engineering چیست، چه تفاوتی با Prompt Engineering دارد، پنجره زمینه چگونه کار میکند، RAG چه نقشی دارد و چگونه میتوان با انتخاب درست اطلاعات، پاسخهای دقیقتر و قابلاعتمادتری از سیستمهای هوش مصنوعی دریافت کرد.
Context Engineering چیست؟
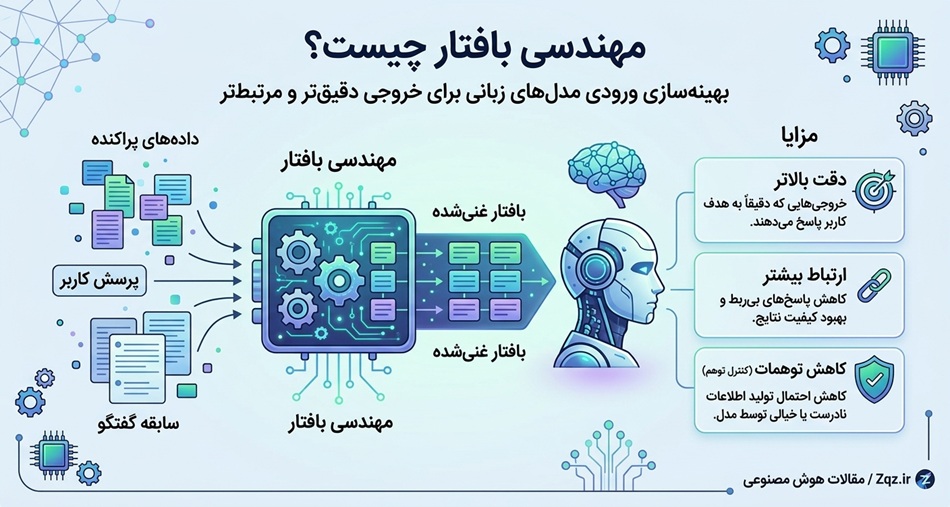
Context Engineering را میتوان مجموعهای از روشها برای انتخاب، سازماندهی، بازیابی و مدیریت اطلاعاتی دانست که در زمان اجرای یک درخواست در اختیار مدل هوش مصنوعی قرار میگیرند.
این اطلاعات ممکن است شامل موارد مختلفی باشند:
- دستورهای اصلی سیستم
- درخواست فعلی کاربر
- بخشهای مرتبط از گفتوگوهای قبلی
- اطلاعات ذخیرهشده در حافظه
- اسناد و فایلهای مرجع
- نتایج جستوجو در پایگاه داده یا وب
- خروجی ابزارهایی که مدل استفاده کرده است
- تعریف ابزارها و روش استفاده از آنها
- خلاصه مراحل قبلی یک وظیفه طولانی
هدف Context Engineering این است که مدل در هر مرحله، اطلاعاتی را دریافت کند که برای انجام همان مرحله لازم است؛ نه اینکه تمام دادههای موجود بدون اولویتبندی در اختیارش قرار بگیرند. به زبان ساده، اگر Prompt Engineering به شما کمک کند سؤال و دستور بهتری بنویسید، Context Engineering کمک میکند اطلاعات مناسبتری را در کنار آن دستور قرار دهید.
یک مثال ساده برای درک Context Engineering
فرض کنید از یک دستیار هوش مصنوعی میخواهید به سؤال مشتری درباره شرایط یک سرویس پاسخ دهد.
اگر فقط این دستور را وارد کنید:
به این مشتری پاسخ بده: «چطور میتوانم لینک خودم را مدیریت کنم؟»
مدل ممکن است پاسخی عمومی ارائه کند؛ زیرا هنوز نمیداند این مشتری از کدام سرویس استفاده میکند، چه امکاناتی در اختیار دارد و منظورش دقیقاً کدام بخش مدیریت لینک است. حالا فرض کنید اطلاعات مرتبط را نیز در اختیار مدل قرار دهیم:
وظیفه: پاسخگویی به سؤال مشتری اطلاعات سرویس: کاربران میتوانند لینکهای خود را از طریق پنل مدیریت کنند. سؤال مشتری: چطور میتوانم لینک خودم را مدیریت کنم؟ محدودیت: فقط بر اساس اطلاعات تأییدشده پاسخ بده. اگر اطلاعات کافی نیست، سؤال دقیقتری بپرس.
در این حالت، مدل برای تولید پاسخ اطلاعات بیشتری دارد و احتمال ارائه راهنمای نامرتبط کمتر میشود. این مثال ساده نشان میدهد که کیفیت پاسخ فقط به عبارتبندی دستور وابسته نیست؛ اطلاعاتی که در زمان پاسخگویی در اختیار مدل قرار میگیرند نیز اهمیت دارند.
تفاوت Prompt Engineering و Context Engineering چیست؟
این دو مفهوم ارتباط نزدیکی با یکدیگر دارند، اما دقیقاً یکسان نیستند. Prompt Engineering بیشتر روی طراحی دستور، مشخص کردن هدف، تعیین قالب خروجی، ارائه مثال و توضیح رفتار مورد انتظار مدل تمرکز دارد.
Context Engineering علاوه بر دستور، کل مجموعه اطلاعات و منابعی را در نظر میگیرد که مدل برای انجام وظیفه به آنها نیاز دارد؛ از تاریخچه گفتوگو و اسناد گرفته تا نتایج جستوجو، ابزارها و خلاصه وضعیت کار.
| موضوع | Prompt Engineering | Context Engineering |
|---|---|---|
| پرسش اصلی | چگونه دستور مناسبی بنویسیم؟ | چه اطلاعاتی باید در اختیار مدل باشد؟ |
| تمرکز اصلی | دستور، قالب و مثالها | انتخاب و مدیریت کل اطلاعات مرتبط |
| روشهای رایج | نوشتن دستور روشن، تعیین نقش و قالب خروجی | بازیابی اسناد، حافظه، خلاصهسازی و مدیریت ابزارها |
| کاربرد مهم | بهبود اجرای یک درخواست | حفظ کیفیت در وظایف پیچیده و چندمرحلهای |
این جدول به معنی جدا بودن کامل دو حوزه نیست. در عمل، Prompt Engineering یکی از بخشهای Context Engineering به شمار میرود و هر دو میتوانند همزمان برای بهبود عملکرد یک سیستم استفاده شوند.
Context Window چیست؟
برای فهم اهمیت Context Engineering باید با مفهومی به نام Context Window یا پنجره زمینه آشنا شویم. مدلهای زبانی اطلاعات ورودی را به واحدهایی به نام Token پردازش میکنند. پنجره زمینه، محدودیتی است که مشخص میکند در یک مرحله پردازش چه مقدار از اطلاعات ورودی و خروجی میتواند در نظر گرفته شود. در یک درخواست واقعی، فقط متن سؤال کاربر مهم نیست. دستورهای سیستم، تاریخچه مکالمه، اسناد بازیابیشده، تعریف ابزارها و دادههای برگشتی از ابزارها نیز ممکن است بخشی از این زمینه را اشغال کنند.
مقدار دقیق ظرفیت Context Window به مدل و پلتفرم مورد استفاده بستگی دارد و در همه مدلها یکسان نیست.
چرا پنجره زمینه اهمیت دارد؟
فرض کنید از هوش مصنوعی میخواهید یک گزارش طولانی را بررسی کند. گزارش شما شامل چندین سند، جدول و توضیح است. علاوه بر آن، گفتوگوی قبلی، دستورهای سیستم و قالب خروجی نیز باید در درخواست قرار بگیرند. در چنین شرایطی، اطلاعات موردنیاز میتوانند بهسرعت زیاد شوند. اگر حجم اطلاعات از ظرفیت مجاز بیشتر شود، سیستم باید بخشی از دادهها را حذف کند، خلاصهسازی انجام دهد یا فقط اطلاعات مرتبط را نگه دارد. بنابراین، یکی از وظایف مهم Context Engineering این است که مشخص کند چه چیزی باید در زمینه فعلی باقی بماند و چه چیزی را میتوان از آن خارج کرد.
آیا Context بزرگتر همیشه به معنی پاسخ بهتر است؟
خیر. این یکی از نکات مهم در طراحی سیستمهای هوش مصنوعی است. داشتن ظرفیت بیشتر برای اطلاعات میتواند مفید باشد؛ مثلاً زمانی که باید اسناد طولانی بررسی شوند. اما قرار دادن تمام اطلاعات در هر درخواست الزاماً نتیجه بهتری تولید نمیکند.
چند مشکل ممکن است به وجود بیاید:
- اطلاعات نامرتبط توجه مدل را از سؤال اصلی منحرف کنند.
- اطلاعات متناقض باعث شوند مدل نتواند منبع مناسب را تشخیص دهد.
- بخش مهمی از پاسخ میان حجم زیادی از متن گم شود.
- هزینه پردازش و زمان پاسخ افزایش پیدا کند.
- مدل در استفاده از بخشهای مهم اطلاعات، عملکرد ضعیفتری نشان دهد.
پژوهشها و تجربههای عملی روی مدلهای دارای Context طولانی نشان دادهاند که افزایش حجم ورودی بهتنهایی تضمین نمیکند تمام اطلاعات با دقت یکسان استفاده شوند. به همین دلیل، یک هدف مهم در Context Engineering این است که اطلاعات مفید و مرتبط را نگه داریم و دادههای غیرضروری را کاهش دهیم.
Context Engineering از چه بخشهایی تشکیل میشود؟
در یک سیستم ساده، ممکن است فقط دستور کاربر و چند خط توضیح وجود داشته باشد. اما یک سیستم حرفهای میتواند از چندین منبع اطلاعاتی استفاده کند.
۱. دستورهای اصلی سیستم
این دستورها رفتار کلی مدل را مشخص میکنند؛ برای مثال نقش آن، محدودیتهای پاسخگویی، قالب خروجی و روش برخورد با ابهام.
۲. درخواست فعلی کاربر
درخواست جاری مشخص میکند مدل در این مرحله باید چه کاری انجام دهد. حتی اگر سیستم اطلاعات زیادی از قبل داشته باشد، باید بتواند هدف فعلی را از میان آن اطلاعات تشخیص دهد.
۳. تاریخچه گفتوگو
تاریخچه مکالمه میتواند برای فهم منظور کاربر، حفظ پیوستگی گفتگو و جلوگیری از پرسیدن دوباره اطلاعات قبلی مفید باشد. با این حال، لازم نیست همیشه تمام تاریخچه بدون تغییر به هر درخواست بعدی اضافه شود. گاهی خلاصهای دقیق از نکات مهم کافی است.
۴. حافظه
سیستمهای دارای حافظه میتوانند برخی اطلاعات پایدار یا ترجیحات مرتبط را برای استفادههای بعدی ذخیره کنند. اما حافظه و Context Window یکی نیستند. حافظه میتواند منبعی برای بازیابی اطلاعات باشد، در حالی که اطلاعات بازیابیشده باید در نهایت به شکل مناسب وارد زمینه درخواست فعلی شوند.
۵. اسناد و دادههای خارجی
اگر سؤال به اطلاعات اختصاصی یک سازمان یا سرویس مربوط باشد، مدل ممکن است لازم داشته باشد بخشهایی از مستندات، پایگاه دانش یا پایگاه داده را دریافت کند. این موضوع بهخصوص در دستیارهای پشتیبانی، تحلیل اسناد و چتباتهای سازمانی اهمیت دارد.
۶. ابزارها و نتایج آنها
یک Agent ممکن است از ابزار جستوجو، API، پایگاه داده یا ابزار اجرای کد استفاده کند. تعریف ابزارها و نتایجی که از آنها بازمیگردند نیز میتوانند در Context نقش داشته باشند. اگر خروجی ابزار بسیار طولانی باشد، ممکن است لازم باشد فقط بخش مرتبط آن نگه داشته شود یا خلاصهای از نتیجه در اختیار مدل قرار بگیرد.
RAG چیست و چه ارتباطی با Context Engineering دارد؟
RAG مخفف Retrieval-Augmented Generation است و به رویکردی اشاره دارد که در آن، قبل از تولید پاسخ، اطلاعات مرتبط از یک یا چند منبع بازیابی میشوند و سپس برای پاسخگویی در اختیار مدل قرار میگیرند. فرض کنید یک شرکت صدها صفحه مستندات دارد. بهجای اینکه تمام اسناد را هر بار وارد درخواست کنیم، سیستم ابتدا سؤال کاربر را بررسی میکند، بخشهای مرتبط را پیدا میکند و فقط همان اطلاعات را در اختیار مدل میگذارد.
مسیر کلی میتواند چنین باشد:
سؤال کاربر
↓
جستوجو در منابع
↓
بازیابی بخشهای مرتبط
↓
ساخت Context
↓
ارسال به مدل
↓
تولید پاسخ
RAG یکی از ابزارهای مهم Context Engineering است، اما این دو مفهوم مترادف نیستند. Context Engineering میتواند علاوه بر بازیابی اطلاعات، مدیریت تاریخچه، حافظه، دستورها، ابزارها، محدودیتها و خلاصهسازی را نیز شامل شود.
چرا RAG همیشه بهترین راهحل نیست؟
هرچند RAG برای بسیاری از سیستمهای مبتنی بر اسناد مناسب است، اما همیشه لازم نیست از آن استفاده کنیم. اگر برنامه فقط به چند تنظیم ثابت نیاز دارد، اضافه کردن سیستم جستوجوی اسناد ممکن است پیچیدگی غیرضروری ایجاد کند. از طرف دیگر، اگر دادهها ساختارمند و قابل پرسوجو باشند، شاید یک Query دقیق از پایگاه داده از بازیابی معنایی متن مناسبتر باشد. به همین دلیل، ابتدا باید منبع داده و نوع سؤال را شناخت و سپس روش مناسب را انتخاب کرد.
Chunking چیست و چرا در بازیابی اطلاعات اهمیت دارد؟
وقتی اسناد طولانی برای جستوجو آماده میشوند، ممکن است به قطعههای کوچکتر تقسیم شوند. به این فرآیند Chunking گفته میشود. برای مثال، یک راهنمای صدصفحهای ممکن است به بخشهایی تقسیم شود که هرکدام موضوع مشخصی را پوشش میدهند.
هنگام دریافت سؤال، سیستم میتواند بهجای بازیابی کل سند، چند قطعه مرتبط را انتخاب کند. تقسیمبندی نامناسب میتواند کیفیت بازیابی را کاهش دهد. اگر هر قطعه بیش از حد کوچک باشد، ممکن است اطلاعات لازم برای فهم مفهوم در بخش دیگری قرار بگیرد. اگر بیش از حد بزرگ باشد، احتمال ورود متن غیرمرتبط به Context افزایش مییابد. بنابراین اندازه قطعهها باید متناسب با ساختار سند و نوع پرسش انتخاب شود.
چگونه اطلاعات مناسب را بازیابی کنیم؟
صرفاً پیدا کردن کلمات مشابه در یک سند کافی نیست. یک سیستم بازیابی خوب باید تلاش کند اطلاعاتی را پیدا کند که واقعاً به هدف درخواست نزدیک هستند. روشهای مختلفی وجود دارند؛ از جستوجوی کلمهای و فیلترهای ساختارمند گرفته تا جستوجوی برداری، ترکیب چند روش و مرتبسازی نتایج.
مثلاً اگر کاربر درباره نحوه تغییر مقصد یک لینک سؤال بپرسد، بازیابی صفحه مربوط به مدیریت لینکها احتمالاً از بازیابی مقالهای عمومی درباره تاریخچه اینترنت مفیدتر است؛ حتی اگر هر دو سند چند کلمه مشترک داشته باشند. در سیستمهای حرفهای ممکن است نتایج بر اساس موضوع، تاریخ، سطح اعتبار منبع یا ارتباط با سؤال نیز فیلتر شوند.
اطلاعات جدید و قدیمی را چگونه مدیریت کنیم؟
یکی از مشکلات رایج در سیستمهای هوش مصنوعی، وجود اطلاعات قدیمی یا متناقض است. فرض کنید یک سرویس در گذشته طرح رایگان با امکانات مشخصی داشته، اما شرایط آن بعداً تغییر کرده است. اگر Context مدل شامل مستندات قدیمی و جدید باشد، ممکن است پاسخ اشتباهی تولید شود.
برای جلوگیری از این مشکل، میتوان اطلاعات را با جزئیاتی مانند موارد زیر همراه کرد:
- منبع اطلاعات
- تاریخ انتشار یا آخرین بهروزرسانی
- نسخه مستندات
- موضوع یا دستهبندی
- وضعیت اعتبار اطلاعات
سپس سیستم میتواند منابع تازهتر یا معتبرتر را در اولویت قرار دهد. البته برای موضوعاتی که تغییرات سریع دارند، تاریخ بهتنهایی کافی نیست و باید اعتبار و ارتباط منبع نیز بررسی شود.
Context Compression یا فشردهسازی زمینه چیست؟
در گفتوگوها و وظایف طولانی، حجم Context بهتدریج افزایش مییابد. بخشی از اطلاعات قبلی ممکن است دیگر برای مرحله فعلی ضروری نباشد. یکی از راهکارها Context Compression یا فشردهسازی زمینه است؛ یعنی کاهش حجم اطلاعات با حفظ نکات مهمی که برای ادامه کار لازم هستند. مثلاً بهجای نگه داشتن دهها پیام درباره یک مسئله برنامهنویسی، میتوان خلاصهای شامل موارد زیر تهیه کرد:
- هدف پروژه
- تصمیمهای قطعی گرفتهشده
- فایلها یا بخشهای تغییرکرده
- خطاهایی که هنوز حل نشدهاند
- مرحله بعدی کار
این روش در Agentهایی که وظایف چندمرحلهای انجام میدهند میتواند بسیار مفید باشد. اما فشردهسازی باید با دقت انجام شود؛ اگر یک محدودیت مهم یا تصمیم حیاتی حذف شود، کیفیت ادامه کار کاهش مییابد.
Memory با Context چه تفاوتی دارد؟
حافظه و Context به هم مرتبطاند، اما نقش متفاوتی دارند. Memory به اطلاعاتی اشاره میکند که برای استفاده در آینده نگهداری میشوند؛ در حالی که Context مجموعه اطلاعاتی است که در یک مرحله مشخص به مدل ارائه میشود. برای مثال، یک دستیار ممکن است به خاطر بسپارد که کاربر از پاسخهای فارسی و مثالهای PHP استفاده میکند. اما برای پاسخ به یک سؤال خاص درباره یک فایل، همچنان باید محتوای مرتبط همان فایل را بازیابی کند. پس حافظهای که بهدرستی طراحی شده باشد میتواند به Context کمک کند، ولی بهتنهایی جایگزین اطلاعات دقیق و بهروز موردنیاز هر درخواست نیست.
چرا دادن اطلاعات بیشتر همیشه بهتر نیست؟
یکی از وسوسههای رایج در طراحی سیستمهای هوش مصنوعی این است که هر اطلاعاتی را که شاید مفید باشد، به درخواست اضافه کنیم. اما اضافه کردن اطلاعات بدون هدف میتواند نتیجه معکوس داشته باشد. مثلاً اگر از مدل بخواهید یک خطای PHP را بررسی کند و همزمان صدها صفحه مستندات نامرتبط، چند نسخه قدیمی کد و تاریخچه کامل یک پروژه را در اختیارش قرار دهید، احتمال دارد توجه آن از علت واقعی خطا منحرف شود. در چنین شرایطی بهتر است ابتدا پیام خطا، بخش کد مربوط، نسخه PHP و اطلاعات لازم درباره محیط اجرا ارائه شوند. سپس در صورت نیاز، اطلاعات بیشتر بازیابی شوند.
کیفیت Context به ارتباط و اعتبار اطلاعات بستگی دارد، نه فقط به حجم آن.
Context Engineering در یک چتبات پشتیبانی چگونه کار میکند؟
یک چتبات پشتیبانی را در نظر بگیرید که باید به پرسش مشتریان یک سرویس آنلاین پاسخ دهد. اگر هر بار تمام راهنمای سرویس، تمام تاریخچه مشتریان و تمام مستندات فنی در اختیار مدل قرار گیرد، هزینه و پیچیدگی زیادی ایجاد میشود.
یک معماری مناسبتر میتواند به این شکل باشد:
سؤال مشتری
    ↓
تشخیص موضوع سؤال
    ↓
بازیابی مستندات مرتبط
    ↓
بررسی اطلاعات حساب در صورت مجاز بودن
    ↓
ساخت Context محدود و مرتبط
    ↓
تولید پاسخ
    ↓
بررسی پاسخ و ارجاع در صورت نیاز
در این معماری، مدل فقط اطلاعاتی را دریافت میکند که برای همان سؤال لازم هستند. اگر موضوع درباره شرایط یک قابلیت باشد، مستندات همان قابلیت بازیابی میشوند. اگر سؤال به وضعیت حساب مشتری مربوط باشد، سیستم باید اطلاعات مرتبط را با رعایت مجوزهای دسترسی دریافت کند. این طراحی میتواند پاسخها را دقیقتر کند و احتمال افشای اطلاعات نامرتبط را نیز کاهش دهد.
Context Engineering برای برنامهنویسی با هوش مصنوعی
Context Engineering فقط مختص چتباتهای پشتیبانی نیست. هنگام استفاده از ابزارهای برنامهنویسی مبتنی بر هوش مصنوعی نیز اهمیت زیادی دارد.
اگر از یک مدل بخواهید یک قابلیت جدید به پروژه اضافه کند، ارائه صرف درخواست ممکن است کافی نباشد. مدل ممکن است به اطلاعاتی درباره معماری موجود، قراردادهای API، ساختار فایلها، نسخه زبان برنامهنویسی و محدودیتهای پروژه نیاز داشته باشد.
برای مثال، بهجای اینکه فقط بنویسید:
قابلیت ورود کاربران را به پروژه اضافه کن.
بهتر است Context مرتبط نیز مشخص شود:
هدف: افزودن قابلیت ورود کاربران محیط: PHP خالص و MySQL ساختار موجود: سیستم کاربران و اتصال دیتابیس از قبل وجود دارد. محدودیتها: - ساختار فعلی پروژه بیدلیل بازنویسی نشود. - رمز عبور به شکل امن بررسی شود. - اعتبارسنجی سمت سرور انجام شود. - فایلهای تغییرکرده گزارش شوند. - تستهای اصلی پس از پیادهسازی اجرا شوند.
این اطلاعات به مدل کمک میکنند تغییر پیشنهادی با واقعیت پروژه سازگارتر باشد. البته همچنان باید خروجی کد را بررسی و آزمایش کرد؛ Context مناسب، تضمینکننده کد بدون خطا نیست.
آیا Context Engineering میتواند خطاهای هوش مصنوعی را حذف کند؟
خیر. این روش میتواند احتمال بعضی خطاها را کاهش دهد، اما نمیتواند همه خطاهای مدل را از بین ببرد. مدل ممکن است همچنان اطلاعات را نادرست تفسیر کند، از یک منبع نامعتبر نتیجه بگیرد یا پاسخی تولید کند که با دادههای موجود سازگار نیست.
برای افزایش قابلیت اعتماد، بهتر است Context Engineering با روشهای دیگری همراه شود:
- ارزیابی پاسخها با نمونههای واقعی
- بررسی صحت پاسخ در برابر منبع
- ارائه ارجاع به اسناد مورد استفاده
- اعتبارسنجی خروجیهای ساختارمند
- محدود کردن دسترسی ابزارها
- درخواست تأیید انسانی برای عملیات حساس
بنابراین، Context Engineering بخشی از معماری یک سیستم قابل اعتماد است؛ نه راهحلی جادویی که بهتنهایی پاسخهای کاملاً صحیح تولید کند.
امنیت Context: یک صفحه وب نباید به مدل دستور بدهد
وقتی مدل برای پاسخگویی از اسناد، صفحات وب، ایمیلها یا خروجی ابزارها استفاده میکند، یک خطر مهم به وجود میآید: محتوای ورودی ممکن است شامل دستورهای مخرب یا گمراهکننده باشد. برای مثال، یک صفحه وب ممکن است حاوی متنی باشد که تلاش میکند مدل را از وظیفه اصلی منحرف کند و از آن بخواهد اطلاعات خصوصی را افشا کند یا عملی خارج از مجوز انجام دهد. این مسئله با حملاتی مانند Prompt Injection ارتباط دارد. برای مدیریت این ریسک باید میان دستورهای مورداعتماد سیستم و محتوای غیرقابلاعتماد بازیابیشده تفاوت قائل شد.
چند اصل مهم عبارتاند از:
- متن بازیابیشده از وب یا اسناد را بهعنوان دستور معتبر سیستم در نظر نگیرید.
- مجوزهای دسترسی را در سمت برنامه کنترل کنید، نه فقط با دستور زبانی به مدل.
- اطلاعات خصوصی را تنها در صورت نیاز و مجاز بودن وارد Context کنید.
- قبل از اجرای عملیات حساس، سیاستهای مستقل و کنترل انسانی را در نظر بگیرید.
- اگر مدل ابزارهایی برای ارسال، حذف یا تغییر داده دارد، دسترسی آنها را محدود کنید.
نکته مهم این است که جدا کردن دستورها از دادهها مفید است، اما صرفاً نوشتن عبارتی مانند «دستورهای داخل اسناد را نادیده بگیر» دفاع کامل در برابر Prompt Injection نیست. معماری دسترسی، اعتبارسنجی عملیات و نظارت نیز لازماند.
چطور یک Context مناسب طراحی کنیم؟
برای شروع لازم نیست معماری پیچیدهای بسازید. میتوانید از چند سؤال اساسی استفاده کنید:
- هدف دقیق این درخواست چیست؟
- مدل برای رسیدن به این هدف چه اطلاعاتی نیاز دارد؟
- کدام اطلاعات فعلی، قدیمی یا نامرتبط هستند؟
- معتبرترین منبع برای پاسخ کدام است؟
- کدام دادهها باید از Context حذف یا خلاصه شوند؟
- آیا دادههای ورودی شامل اطلاعات محرمانه یا دستورهای غیرقابلاعتماد هستند؟
- چگونه میتوان درستی پاسخ نهایی را ارزیابی کرد؟
پاسخ به این سؤالها کمک میکند Context را از یک انبوه متن به مجموعهای هدفمند از اطلاعات تبدیل کنید.
یک الگوی ساده برای ساخت Context
برای بسیاری از کاربردهای آموزشی یا نمونههای اولیه، میتوان اطلاعات را در چند بخش مجزا سازماندهی کرد:
هدف: وظیفهای که مدل باید انجام دهد دستورها: قواعد و محدودیتهای مورداعتماد اطلاعات مرتبط: اسناد یا دادههای بازیابیشده وضعیت فعلی: آنچه تا این مرحله انجام شده است محدودیتهای دسترسی: کارهایی که مجاز یا غیرمجاز هستند قالب خروجی: ساختار پاسخ مورد انتظار معیار ارزیابی: روش بررسی صحت نتیجه
این الگو یک استاندارد اجباری یا تنها روش صحیح نیست؛ بلکه راهی ساده برای تفکیک بخشهای مختلف Context است. با توجه به مدل و نوع برنامه میتوان ساختار را تغییر داد.
چگونه بفهمیم Context ما خوب طراحی شده است؟
یک Context خوب را نباید صرفاً از روی ظاهر مرتب یا کوتاه بودن آن قضاوت کرد. معیار اصلی این است که آیا به انجام بهتر وظیفه کمک میکند یا خیر. برای ارزیابی میتوانید مجموعهای از پرسشها و پاسخهای مورد انتظار تهیه کنید و چند نسخه از Context را روی آنها آزمایش کنید.
برای مثال، میتوان این موارد را مقایسه کرد:
- پاسخ مدل با پرامپت تنها
- پاسخ مدل با پرامپت و اسناد مرتبط
- پاسخ مدل با اسناد مرتبط و تاریخچه خلاصهشده
- پاسخ مدل با منابع تازهتر و محدودیتهای روشن
سپس دقت پاسخ، میزان استفاده از منابع صحیح، تعداد ادعاهای بدون پشتوانه، زمان اجرا و هزینه را بررسی کنید. اگر اضافه کردن دادههای بیشتر فقط هزینه را بالا ببرد و کیفیت را بهتر نکند، احتمالاً لازم است روش بازیابی یا انتخاب Context را بازنگری کنید.
آیا Context Engineering فقط برای Agentهاست؟
خیر. این رویکرد برای چتباتهای ساده، سامانههای پاسخگویی به اسناد، دستیارهای برنامهنویسی، ابزارهای تحلیل داده و Agentهای چندمرحلهای میتواند مفید باشد. با این حال، هرچه وظیفه طولانیتر و تعداد ابزارها بیشتر شود، مدیریت Context معمولاً اهمیت بیشتری پیدا میکند؛ زیرا وضعیت کار، خروجی ابزارها، تصمیمهای گذشته و اطلاعات جدید همگی ممکن است روی مرحله بعد تأثیر بگذارند. برای یک سؤال ساده شاید چند خط Context کافی باشد، اما یک Agent که باید در چندین مرحله تحقیق کند، فایلها را تغییر دهد و نتیجه را اعتبارسنجی کند، به روش منسجمتری برای مدیریت اطلاعات نیاز دارد.
آیا برای هر پروژه هوش مصنوعی به Context Engineering نیاز داریم؟
لازم نیست برای تمام پروژهها یک سیستم پیچیده حافظه، بازیابی اسناد و فشردهسازی Context طراحی کنیم. اگر از مدل برای تولید یک عنوان کوتاه یا اصلاح یک جمله استفاده میکنید، احتمالاً یک پرامپت روشن کافی است. اما اگر سیستم شما باید به مستندات داخلی پاسخ دهد، اطلاعات بهروز را بررسی کند، گفتوگوهای طولانی را ادامه دهد یا چند مرحله کار را با استفاده از ابزارها اجرا کند، طراحی Context میتواند تأثیر قابلتوجهی داشته باشد. اصل مهم این است که پیچیدگی معماری باید متناسب با مسئله واقعی باشد؛ نه اینکه صرفاً به دلیل جدید بودن یک اصطلاح، ابزارهای بیشتری به پروژه اضافه کنیم.
جمعبندی
Context Engineering رویکردی برای طراحی و مدیریت اطلاعاتی است که مدل هوش مصنوعی در زمان انجام یک درخواست در اختیار دارد. این اطلاعات میتوانند شامل دستورهای اصلی، تاریخچه گفتگو، حافظه، اسناد، دادههای خارجی و خروجی ابزارها باشند. تفاوت مهم آن با Prompt Engineering این است که فقط به بهتر نوشتن دستور فکر نمیکند؛ بلکه بررسی میکند چه اطلاعاتی باید همراه آن دستور در اختیار مدل قرار بگیرند.
مفاهیمی مانند Context Window، RAG، Chunking، Memory و Context Compression ابزارها و روشهایی هستند که میتوانند در این مسیر نقش داشته باشند. با این حال، هیچکدام بهتنهایی تضمینکننده پاسخ صحیح نیستند و انتخاب آنها باید متناسب با نیاز پروژه انجام شود. همچنین امنیت Context اهمیت زیادی دارد. اطلاعات بازیابیشده از وب یا اسناد نباید بهطور خودکار در جایگاه دستورهای مورداعتماد قرار بگیرند و دسترسی ابزارها باید مستقل از متن تولیدشده توسط مدل کنترل شود.
در نهایت، برای ساخت یک سیستم هوش مصنوعی قابلاعتماد، فقط پرسیدن یک سؤال خوب کافی نیست. باید مطمئن شویم مدل اطلاعات مرتبط، معتبر و بهاندازه کافی دقیق را دریافت میکند و نتیجه نهایی نیز قابل ارزیابی است.
گاهی بهجای اینکه پرامپت را پیچیدهتر کنیم، باید Context را هوشمندانهتر بسازیم.